Les génogrammes sont largement utilisés dans la recherche et la pratique professionnelle pour analyser les schémas familiaux. Mais lorsque chaque cas est documenté différemment, la comparaison des génogrammes devient difficile. Les champs de données manquants, les détails relationnels peu clairs et les sources non documentées peuvent réduire la fiabilité des ensembles de données familiales, même lorsqu’un génogramme semble visuellement complet. Un score d’exhaustivité des données d’un génogramme aide les chercheurs à évaluer si un génogramme contient les informations structurées nécessaires pour l’analyse, l’évaluation ou la documentation.
Dans ce guide, vous découvrirez comment fonctionne le scoring d’exhaustivité, comment appliquer un cadre pratique de notation de 0 à 100 et comment maintenir une fiabilité cohérente des génogrammes dans la recherche sur plusieurs cas.
Qu’est-ce que l’exhaustivité des données d’un génogramme ?
L’exhaustivité des données d’un génogramme fait référence à la quantité d’informations requises qui ont été collectées.
Un génogramme prêt pour la recherche comprend généralement :
- Tous les membres pertinents de la famille dans le périmètre défini de l’étude, y compris les générations requises et les liens de parenté
- Des variables démographiques standardisées, telles que l’âge ou l’année de naissance, le sexe ou la catégorie de genre, ainsi que le statut vivant ou décédé
- Les événements, conditions ou variables comportementales pertinents pour l’étude, enregistrés à l’aide de définitions cohérentes
- Des indicateurs clairement définis des relations biologiques, légales ou sociales afin de soutenir une analyse précise de la structure familiale
- Des sources de données documentées pour les informations clés, telles que les entretiens, les dossiers ou les rapports vérifiés
- Des marqueurs explicites pour les données inconnues, manquantes ou non applicables, permettant une évaluation transparente de l’exhaustivité
Pourquoi l’exhaustivité est importante pour la qualité de la recherche
L’exhaustivité des données d’un génogramme fait référence à la quantité d’informations requises qui ont été collectées. Un génogramme peut sembler complet visuellement tout en manquant de données structurées essentielles à l’analyse.
Les génogrammes incomplets peuvent entraîner :
- Des schémas non détectés : les tendances héréditaires ou comportementales peuvent rester invisibles si des membres clés de la famille ou certaines conditions ne sont pas documentés.
- Des comparaisons peu fiables : lorsque différents génogrammes contiennent des niveaux de détail différents, les comparaisons deviennent difficiles.
- Des biais dans les résultats de recherche : les données manquantes ou inégalement documentées peuvent fausser l’interprétation, notamment lors de comparaisons entre plusieurs familles ou groupes de cas.
- Une reproductibilité réduite : les futurs chercheurs peuvent avoir des difficultés à interpréter ou vérifier les résultats si les données d’origine sont incomplètes.
Dans ce guide, la préparation à la recherche signifie qu’un génogramme contient suffisamment de données structurées, interprétables et documentées pour être utilisé de manière fiable dans l’analyse ou comparé entre différents cas.
Qu’est-ce que le scoring d’exhaustivité des données ?
Le scoring d’exhaustivité des données répond à une question importante :
Ce génogramme est-il prêt pour l’analyse ?
Au lieu de s’appuyer sur un jugement subjectif, les chercheurs attribuent un score d’exhaustivité en fonction de la quantité d’informations requises qui a été collectée.
Un champ de données est généralement considéré comme complet lorsque :
- L’information est présente
- Les données sont interprétables
- L’information est pertinente pour l’objectif du génogramme
- La source est documentée lorsque nécessaire
- Les valeurs inconnues sont clairement indiquées
L’utilisation d’un système de notation aide les équipes à évaluer les génogrammes de manière cohérente entre les cas et les ensembles de données.
Le système de notation d’exhaustivité des génogrammes de 0 à 100
Une manière pratique de mesurer l’exhaustivité d’un génogramme consiste à utiliser une échelle de notation de 0 à 100.
Ce pourcentage reflète la quantité d’informations requises qui a été collectée pour l’usage prévu du génogramme.
| Plage de score | Catégorie | Description |
|---|---|---|
| 0–19 | Vide | Structure minimale ou seulement quelques individus enregistrés. Inutilisable pour l’analyse. |
| 20–39 | Minimal | Structure familiale de base présente mais variables ou relations clés manquantes. |
| 40–59 | Basique | Les relations principales sont incluses avec certains attributs, mais de nombreuses lacunes subsistent. |
| 60–79 | Bon | La plupart des champs requis sont renseignés ; adapté à de nombreuses analyses avec quelques limitations. |
| 80–100 | Complet | Les champs de données requis sont largement remplis, les sources suivies et les valeurs inconnues documentées. |
Les seuils exacts peuvent être ajustés selon la conception de l’étude, mais cette échelle fournit un cadre commun pratique pour les revues d’équipe.
Exemple de modèle de notation
Un système de notation pratique peut attribuer différents poids aux composants de données :
- Exhaustivité de la structure familiale — 40 %
- Exhaustivité des champs requis — 30 %
- Documentation des sources — 15 %
- Indicateurs de certitude ou d’inconnu — 10 %
- Statut de révision ou de vérification — 5 %
La notation pondérée garantit que les variables critiques influencent davantage le score que les données optionnelles.
Champs essentiels que chaque génogramme de recherche devrait inclure
Bien que les génogrammes varient selon leur objectif, certains éléments de données apparaissent dans la plupart des ensembles de données familiales de qualité recherche.
Informations individuelles
- Identifiant unique ou ID de recherche
- Sexe ou catégorie de genre utilisée dans l’étude
- Année de naissance ou âge
- Statut vivant ou décédé
Structure familiale
- Relations parent-enfant
- Relations de couple
- Relations fraternelles
- Relations biologiques versus adoptives ou recomposées
Santé ou événements de vie
- Conditions significatives
- Événements majeurs de la vie
- Âge d’apparition lorsque pertinent
Informations de documentation
- Source des données
- Niveau de certitude
- Marqueur de valeur inconnue
- Date de dernière mise à jour
Dans la pratique, de nombreuses équipes de recherche suivent les sources des données et signalent les incertitudes afin d’évaluer la fiabilité de chaque point de données, notamment lorsque les informations proviennent d’entretiens ou de dossiers historiques.
Champs requis spécifiques aux cas d’utilisation
Tous les génogrammes ne collectent pas les mêmes informations. Les champs requis dépendent de la raison pour laquelle le génogramme est créé. Par exemple, les génogrammes médicaux se concentrent sur les conditions héréditaires, tandis que les génogrammes thérapeutiques explorent les dynamiques émotionnelles.
| Type de génogramme | Champs requis typiques | Objectif |
|---|---|---|
| Génogrammes médicaux | Relations biologiques multigénérationnelles, données démographiques (sexe, âge ou année de naissance), informations sur les décès, diagnostics et âge d’apparition, origine ancestrale pertinente, historique reproductif, résultats de tests génétiques | Favorise l’identification des schémas de maladies héréditaires et l’évaluation des risques génétiques |
| Génogrammes thérapeutiques | Indicateurs de qualité relationnelle, schémas émotionnels, structures de conflit ou d’alliance, événements de vie significatifs ou traumatismes, contexte culturel et migratoire, relations clés non biologiques | Aide à analyser les dynamiques familiales et les influences systémiques sur le comportement |
| Génogrammes en travail social | Rôles de soins, composition du foyer, contexte de tutelle ou de garde, réseaux de soutien, implication des services, facteurs de risque et de protection, ruptures familiales | Soutient l’évaluation du fonctionnement familial et des systèmes de soutien social |
| Génogrammes juridiques | Liens de parenté vérifiés, historique des mariages et adoptions, relations pertinentes pour les successions, structures de bénéficiaires, preuves documentaires, relations contestées ou juridiquement disputées | Clarifie les relations familiales légalement reconnues pour l’analyse et la documentation des cas |
| Génogrammes de recherche | Identifiants d’étude, variables codées standardisées, définitions opérationnelles, sources de données documentées, indicateurs de certitude, marqueurs de données manquantes, historiques de révision ou de mise à jour | Favorise un codage cohérent, une gestion transparente des données manquantes et la comparabilité entre ensembles de données de génogrammes |
Comment calculer un score d’exhaustivité de génogramme
Le calcul d’un score d’exhaustivité de génogramme fournit un moyen pratique d’estimer dans quelle mesure un génogramme est prêt pour l’analyse. Plutôt que de supposer qu’un diagramme est exploitable, les chercheurs peuvent vérifier si les informations requises ont été collectées.
L’approche de notation de 0 à 100 décrite ici constitue un cadre utile pour évaluer l’exhaustivité. Elle peut être adaptée selon la conception de l’étude, le contexte professionnel ou les exigences de documentation.
Étape 1 — Définir les champs requis
Commencez par identifier les informations que votre génogramme doit inclure selon son utilisation prévue.
Par exemple :
- Les génogrammes médicaux peuvent privilégier les diagnostics et l’âge d’apparition
- Les génogrammes thérapeutiques peuvent mettre l’accent sur les dynamiques relationnelles
- Les génogrammes de recherche peuvent nécessiter des identifiants d’étude et le suivi des sources
Ces champs requis constituent l’ensemble de données de référence utilisé pour évaluer l’exhaustivité.
Étape 2 — Examiner les données enregistrées et les sources d’information
Ensuite, vérifiez si chaque élément de données requis a été documenté.
À cette étape, il est également important d’enregistrer la provenance des informations.
Les données familiales peuvent provenir de plusieurs sources, telles que :
- entretiens avec les participants ou la famille
- dossiers médicaux ou cliniques
- certificats de naissance, de décès ou de mariage
- recensements ou archives historiques
- documents successoraux ou juridiques
- résultats de tests génétiques
- déductions des chercheurs basées sur les preuves disponibles
L’enregistrement des sources d’information aide les chercheurs à déterminer si les données sont vérifiées, estimées ou incertaines, et facilite l’interprétation des évaluations d’exhaustivité.
Si des informations ne sont pas disponibles, indiquez Inconnu plutôt que de laisser le champ vide.
Étape 3 — Estimer le pourcentage d’exhaustivité
Une méthode simple pour évaluer l’exhaustivité consiste à comparer le nombre de champs requis renseignés avec le nombre total de champs définis pour le génogramme.
Exemple :
Champs requis : 20
Champs complétés : 15
Score estimé d’exhaustivité :
15 ÷ 20 = 75 %
Ce pourcentage fournit une indication générale du niveau d’exhaustivité de l’ensemble de données.
Étape 4 — Interpréter le résultat
Les chercheurs peuvent utiliser les plages d’exhaustivité comme guide pratique pour évaluer la préparation à l’analyse.
Par exemple :
- 0–19 — Informations très limitées enregistrées
- 20–39 — Structure de base présente mais lacunes importantes
- 40–59 — Certaines données clés capturées avec des éléments manquants notables
- 60–79 — La plupart des informations requises sont présentes
- 80–100 — Couverture substantielle des champs de données définis
Ces plages ne constituent pas des normes fixes, mais elles peuvent aider les équipes à déterminer si une collecte de données ou une vérification supplémentaire est nécessaire avant d’utiliser le génogramme pour la recherche ou la documentation professionnelle.
Exemple de score d’exhaustivité
L’exemple suivant montre comment un score d’exhaustivité de génogramme peut être calculé à l’aide de composants pondérés.
| Composant | Score |
|---|---|
| Exhaustivité de la structure familiale | 32 / 40 |
| Complétion des champs requis | 23 / 30 |
| Documentation des sources | 9 / 15 |
| Indicateurs de certitude | 6 / 10 |
| Statut de révision | 3 / 5 |
Score total : 73 / 100 — Bon
Ce génogramme contient la plupart des informations requises, mais certaines lacunes subsistent. Par exemple, une documentation de source manquante ou des données incertaines peuvent réduire la confiance dans l’interprétation entre différents cas.
Même lorsqu’un génogramme obtient un bon score, il reste important d’examiner les données pour vérifier leur cohérence, leur validation et leur alignement avec les objectifs de recherche.
Modèles de scoring d’exhaustivité des données de génogramme
1. Modèle basique de scoring d’exhaustivité des données de génogramme
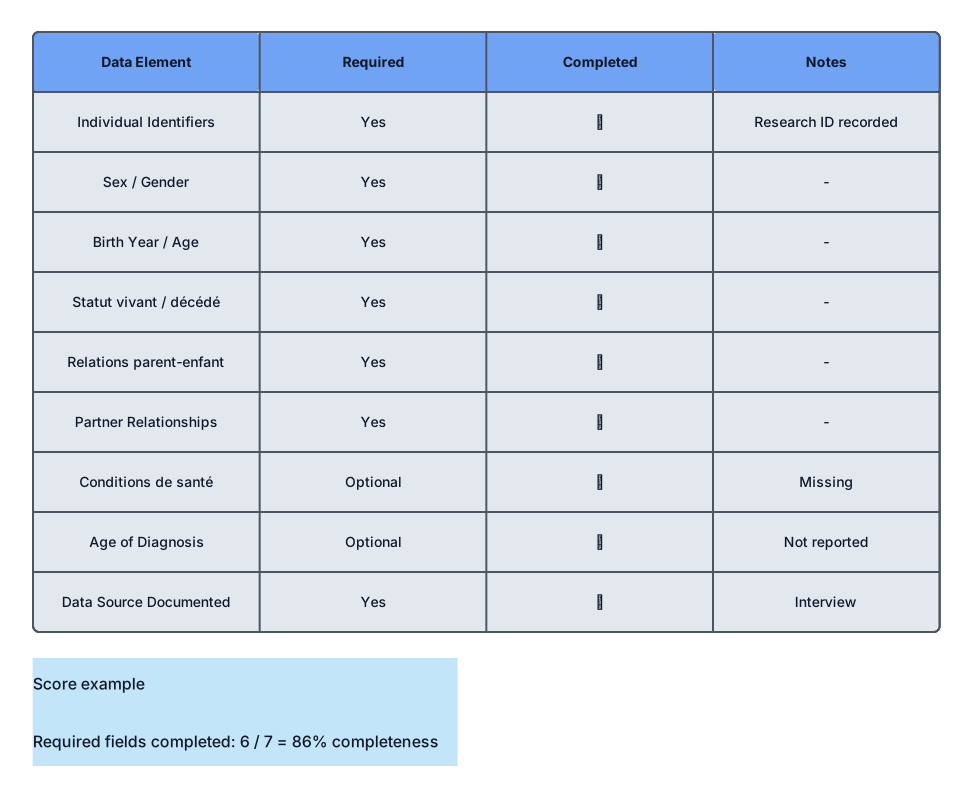
Ce modèle simple convient bien aux examens de cas individuels ou aux petites études. Il aide les chercheurs à vérifier si les champs de données essentiels d’un génogramme ont été collectés. Chaque élément de données requis est marqué comme complété ou manquant, ce qui facilite le calcul d’un score global d’exhaustivité.
- Prêt à l’emploi
- Modèle entièrement personnalisable
- Commencez en quelques secondes
 Close
2. Modèle pondéré de scoring d’exhaustivité des génogrammes
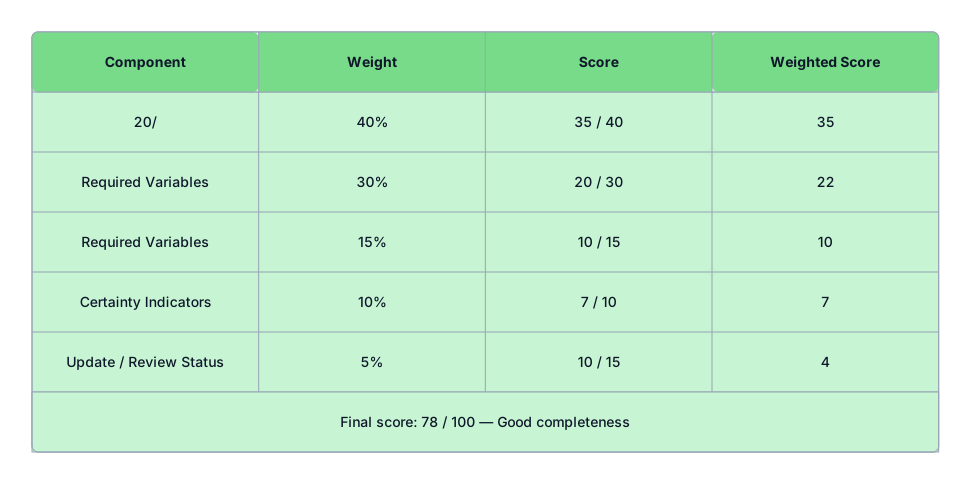
Ce modèle est utile pour des projets de recherche plus structurés où différents types de données ont différents niveaux d’importance.
Par exemple, les informations essentielles sur la structure familiale peuvent avoir un poids plus élevé que des métadonnées de support telles que les notes de documentation ou le statut de mise à jour.
- Prêt à l’emploi
- Modèle entièrement personnalisable
- Commencez en quelques secondes
Close3. Modèle d’ensemble de données de génogrammes multi-cas
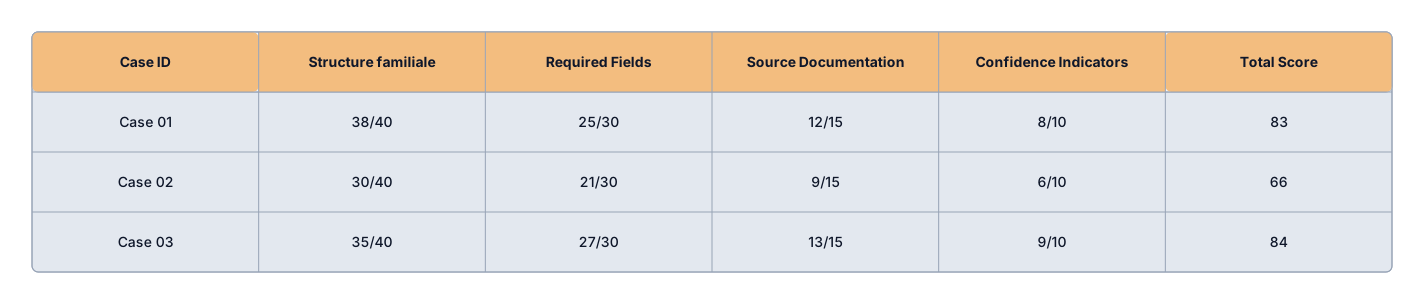
Ce modèle est conçu pour de grands ensembles de données de recherche impliquant plusieurs familles ou études de cas.
Il permet aux chercheurs de comparer les scores d’exhaustivité entre plusieurs génogrammes et d’identifier rapidement les cas nécessitant une collecte de données ou une vérification supplémentaire.
- Prêt à l’emploi
- Modèle entièrement personnalisable
- Commencez en quelques secondes
Close4. Modèle d’exhaustivité des données au niveau individuel
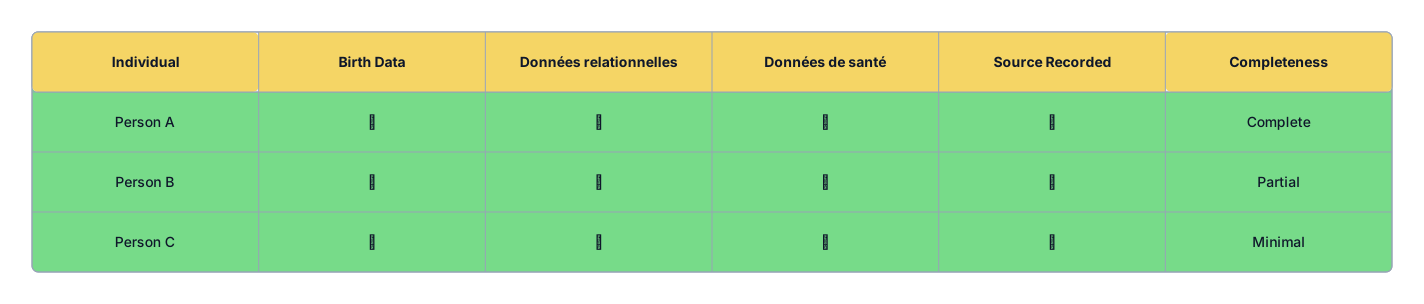
Au lieu de noter l’ensemble d’un génogramme en une seule fois, ce modèle évalue l’exhaustivité au niveau individuel. Cette approche fonctionne bien pour les grandes structures familiales où certaines personnes peuvent avoir des données incomplètes.
Les chercheurs peuvent ensuite calculer un score d’exhaustivité au niveau familial en fonction de l’exhaustivité de chaque enregistrement individuel.
- Prêt à l’emploi
- Modèle entièrement personnalisable
- Commencez en quelques secondes
CloseUtiliser Creately pour créer et examiner des génogrammes complets
Maintenir des ensembles de données de génogrammes complets et cohérents peut être difficile, en particulier dans les contextes de recherche impliquant plusieurs familles, des dossiers évolutifs ou une collecte de données collaborative.
L’utilisation d’une plateforme visuelle structurée comme Creately peut aider les chercheurs à collecter les informations requises de manière plus systématique et à examiner les génogrammes plus efficacement lors de l’application des méthodes de scoring d’exhaustivité.
Voici quelques façons dont Creately peut soutenir une documentation de génogrammes prête pour la recherche.
Documenter les relations familiales de manière cohérente
Creately fournit une notation structurée des relations qui peut aider les chercheurs à représenter clairement les connexions biologiques, légales et sociales. Cela favorise l’exhaustivité de la structure familiale, en facilitant la vérification que les liens de parenté et les relations générationnelles requis ont bien été enregistrés avant la notation de l’ensemble de données.
Capturer des données structurées dans chaque dossier individuel
Les chercheurs peuvent attacher des champs de données structurés directement aux individus du génogramme. Ces champs peuvent inclure des variables démographiques, des conditions pertinentes pour l’étude, des rôles juridiques ou des identifiants de recherche. Cela soutient l’exhaustivité des champs requis et permet aux équipes de vérifier si les variables essentielles ont été collectées pour chaque cas.
Générer des génogrammes initiaux à partir de notes de cas
La fonctionnalité texte-vers-génogramme de Creately peut aider les chercheurs à créer un diagramme familial de base à partir de résumés d’entretiens ou de descriptions de cas. L’établissement d’une structure initiale dès le début du processus de documentation soutient l’initialisation de l’ensemble de données et l’examen de l’exhaustivité, ce qui facilite l’identification des individus ou relations manquants.
Examiner plus facilement les grandes familles multigénérationnelles
Les fonctionnalités de mise en page automatique aident à maintenir la lisibilité à mesure que les génogrammes s’étendent sur plusieurs générations. Cela peut soutenir la vérification structurelle, permettant aux chercheurs d’identifier rapidement les lacunes telles que des proches non enregistrés, des liens relationnels peu clairs ou des branches incomplètes susceptibles d’affecter le scoring d’exhaustivité.
Favoriser la révision collaborative des données
Les espaces de travail partagés permettent à plusieurs contributeurs d’examiner et d’affiner les génogrammes au fil du temps. La révision collaborative soutient le statut de mise à jour et de vérification, aidant les équipes à confirmer la précision des données, à documenter les modifications et à maintenir des niveaux d’exhaustivité plus cohérents entre plusieurs cas.