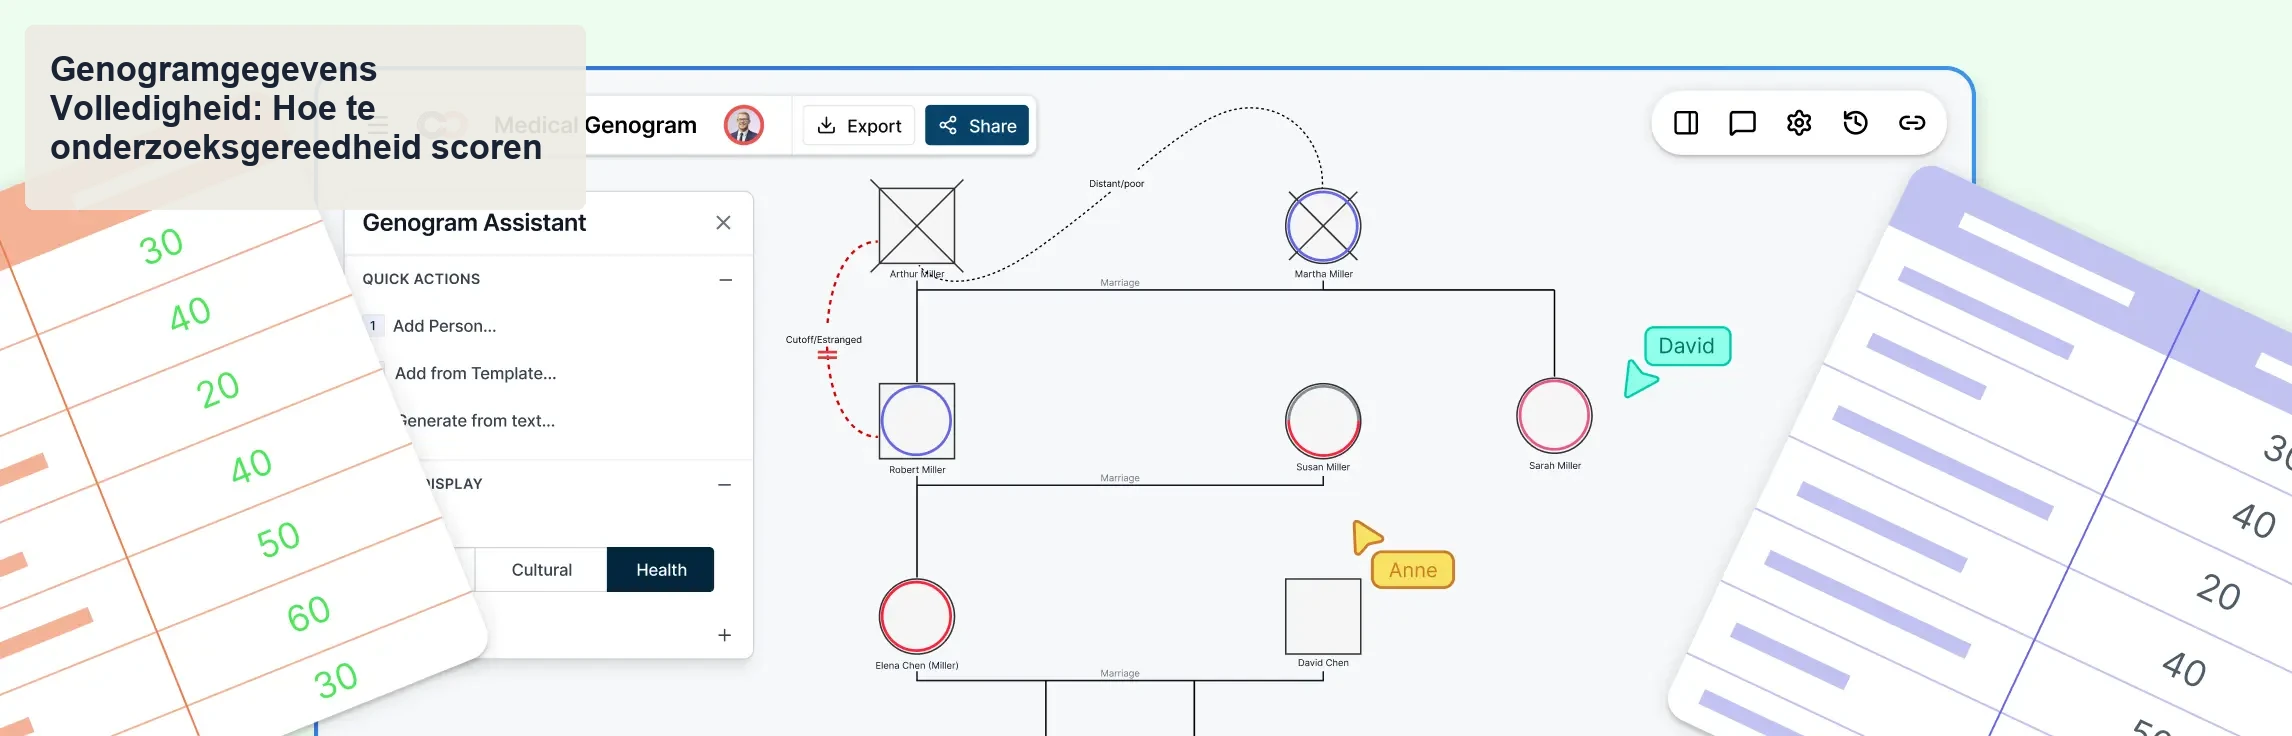
Genogrammen worden op grote schaal gebruikt in onderzoek en professionele praktijk om patronen tussen families te analyseren. Maar als elk geval anders wordt gedocumenteerd, wordt het vergelijken van genogrammen moeilijk. Ontbrekende gegevensvelden, onduidelijke relatiedetails en ongedocumenteerde bronnen kunnen de betrouwbaarheid van familiedatasets verminderen, zelfs wanneer een genogram er visueel compleet uitziet. Een genogram gegevensincompatibiliteit score helpt onderzoekers beoordelen of een genogram de gestructureerde informatie bevat die nodig is voor analyse, beoordeling of documentatie.
In deze gids leert u hoe volledigheidsscores werken, hoe u een praktisch scoringskader van 0
Wat is gegevensvolledigheid in een genogram?
De volledigheid van de genogramgegevens verwijst naar hoeveel van de vereiste informatie voor een genogram is gevangen.
Een onderzoek-ready genogram omvat meestal:
- Alle relevante familieleden binnen de gedefinieerde studieomvang, inclusief vereiste generaties en verwantschapsbanden
- Gestandaardiseerde demografische variabelen, zoals leeftijd of geboortejaar, geslacht of geslachtscategorie, en levende of overleden status
- Studie-relevante gebeurtenissen, aandoeningen, of gedragsvariabelen, geregistreerd met behulp van consistente definities
- Duidelijk omschreven biologische, juridische of sociale relatie indicatoren ter ondersteuning van nauwkeurige familiestructuur analyse
- Gedocumenteerde gegevensbronnen voor belangrijke informatie, zoals interviews, verslagen of geverifieerde rapporten
- Expliciete markers voor onbekende, ontbrekende of niet-toepasselijke gegevens, waardoor transparante volledigheidsbeoordeling mogelijk is
Waarom volledigheid belangrijk is voor onderzoekskwaliteit
De volledigheid van de genogramgegevens verwijst naar hoeveel van de vereiste informatie voor een genogram is gevangen. Een genogram kan er visueel compleet uitzien terwijl nog steeds kritieke gestructureerde gegevens ontbreken die nodig zijn voor analyse.
Onvolledige genogrammen kunnen leiden tot:
- Vermiste patronen: Erfelijke of gedragstrends kunnen verborgen blijven als belangrijke familieleden of aandoeningen niet worden gedocumenteerd.
- Onbetrouwbare vergelijkingen: Wanneer verschillende genogrammen verschillende detailniveaus bevatten, wordt het moeilijk ze te vergelijken.
- Bias in onderzoeksresultaten: Ontbrekende gegevens of ongelijk gedocumenteerde gegevens kunnen de interpretatie verstoren, vooral bij het vergelijken van meerdere families of casegroepen.
- Verminderde reproduceerbaarheid: Toekomstige onderzoekers kunnen moeite hebben om de bevindingen te interpreteren of te verifiëren als de oorspronkelijke gegevens onvolledig zijn.
In deze gids betekent onderzoek gereedheid dat een genogram voldoende gestructureerde, interpreteerbare en gedocumenteerde gegevens bevat om betrouwbaar te worden gebruikt in analyse of vergeleken tussen gevallen.
Wat is scoring voor gegevensvolledigheid?
Gegevens volledigheid scoren beantwoordt een belangrijke vraag:
Is dit genogram klaar voor analyse?
In plaats van te vertrouwen op subjectieve beoordeling, geven onderzoekers een volledigheidsscore op basis van hoeveel van de vereiste informatie is gevangen.
Een gegevensveld wordt over het algemeen als volledig beschouwd wanneer:
- De informatie is aanwezig
- De gegevens zijn te interpreteren
- De informatie is relevant voor het doel van het genogram
- De bron wordt gedocumenteerd indien nodig
- Onbekende waarden zijn duidelijk gemarkeerd
Met behulp van een scoresysteem kunnen teams genogrammen consistent evalueren tussen gevallen en datasets.
Het 0-100 scoresysteem voor genogramvolledigheid
Een praktische manier om de volledigheid van het genogram te meten is door gebruik te maken van een scoreschaal van 0/0100. Dit percentage geeft aan hoeveel van de vereiste informatie is verzameld voor het beoogde gebruik van het genogram.
| Scorebereik | Categorie | Beschrijving |
|---|---|---|
| 0–19 | Leeg | Minimale structuur of slechts een paar individuen geregistreerd. Niet bruikbaar voor analyse. |
| 20–39 | Minimaal | Fundamentele familiestructuur aanwezig maar ontbrekende belangrijke variabelen of relaties. |
| 40–59 | Basis | Core relaties zijn opgenomen met een aantal attributen, maar veel hiaten blijven. |
| 60–79 | Goed | De meeste benodigde velden gevangen; geschikt voor vele analyses met enkele beperkingen. |
| 80–100 | Voltooid | Vereiste gegevensvelden grotendeels gevuld, bronnen bijgehouden, en onbekende waarden gedocumenteerd. |
De exacte drempels kunnen worden aangepast door studieontwerp, maar de schaal biedt een praktisch gedeeld kader voor teamevaluatie.
Voorbeeld van een scoringsmodel
Een praktisch scoresysteem kan verschillende gegevenscomponenten wegen:
- Volledigheid van de gezinsstructuur
- Vereiste veldcompatibiliteit 30%
- Bron documentatie
- Zekerheid of onbekende markers 10%
- Status van beoordeling of verificatie: 5%
Gewogen scoren zorgt ervoor dat kritieke variabelen de score meer beïnvloeden dan optionele gegevens.
Kernvelden die elk onderzoeksgenogram moet vastleggen
Hoewel genogrammen per doel verschillen, komen bepaalde gegevenselementen voor in de meeste familiedatasets van onderzoekskwaliteit.
Persoonlijke informatie
- Unieke identificatie- of onderzoeks-ID
- Geslacht of geslachtscategorie gebruikt in de studie
- Geboortejaar of leeftijd
- Levende of overleden status
Familiestructuur
- Ouder-kind relaties
- Partnerrelaties
- Verwante relaties
- Biologische vs adoptie of stap relaties
Gezondheids- of levensgebeurtenissen
- Belangrijke aandoeningen
- Grote gebeurtenissen in het leven
- Leeftijd van aanvang indien relevant
Informatie over de documentatie
- Gegevensbron
- Zekerheidsniveau
- Onbekende waardemarkering
- Laatst bijgewerkt
In de praktijk volgen veel onderzoeksteams gegevensbronnen en merken ze onzekerheid op, zodat ze kunnen beoordelen hoe betrouwbaar elk datapunt is, vooral wanneer informatie afkomstig is van interviews of historische gegevens.
Vereiste velden per gebruiksscenario
Niet alle genogrammen verzamelen dezelfde informatie. De benodigde velden zijn afhankelijk van waarom het genogram wordt aangemaakt. Medische genogrammen richten zich bijvoorbeeld op erfelijke aandoeningen, terwijl therapiegenogrammen emotionele dynamiek onderzoeken.
| Type genogram | Typische verplichte velden | Doel |
|---|---|---|
| Medische genogrammen | Multigenerationele biologische relaties, demografische gegevens (geslacht, leeftijd of geboortejaar), overlijdensinformatie, diagnoses en leeftijd van het begin, relevante voorouders, reproductiegeschiedenis, resultaten van genetische tests | Ondersteunt identificatie van erfelijke ziektepatronen en genetische risicobeoordeling |
| Genogram therapie | Kwaliteitsindicatoren voor relaties, emotionele patronen, conflict- of alliantiestructuren, belangrijke gebeurtenissen of trauma’s, culturele en migratiecontext, belangrijke niet-biologische relaties | Helpt bij het analyseren van familiedynamiek en systemische invloeden op gedrag |
| Genogrammen sociaal werk | Caregiving rollen, huishoudelijke samenstelling, voogdij of voogdij context, ondersteunende netwerken, betrokkenheid van de dienst, risico en beschermende factoren, familie verstoringen | Ondersteunt de beoordeling van het functioneren van het gezin en sociale ondersteuningssystemen |
| Juridische genogrammen | Geverifieerde verwantschapsbanden, huwelijks- en adoptiegeschiedenis, successie-relevante relaties, begunstigde structuren, bewijsstukken, betwiste of juridisch betwiste relaties | Verduidelijkt wettelijk erkende familierelaties voor casus analyse en documentatie |
| Onderzoeksgenogrammen | Studie-identificaties, gestandaardiseerde gecodeerde variabelen, operationele definities, gedocumenteerde gegevensbronnen, zekerheidsindicatoren, ontbrekende gegevensmarkers, herziening of update records | Ondersteunt consistente codering, transparante verwerking van ontbrekende gegevens en vergelijkbaarheid tussen genogramdatasets |
Hoe bereken je een genogramvolledigheidsscore?
Het berekenen van een genogram volledigheid score biedt een praktische manier om te schatten hoe klaar een genogram is voor analyse. In plaats van aan te nemen dat een diagram bruikbaar is, kunnen onderzoekers beoordelen of de vereiste informatie is gevangen.
De hier beschreven benadering van 0/100 is een nuttig kader voor de beoordeling van volledigheid. Het kan worden aangepast afhankelijk van de studie ontwerp, professionele context, of documentatie eisen.
Stap 1. — Definieer de verplichte velden
Begin met het identificeren van de informatie die uw genogram moet bevatten op basis van het beoogde gebruik.
Bijvoorbeeld:
- Medische genogrammen kunnen voorrang geven aan diagnoses en leeftijd van het begin
- Therapie-genograms kunnen de relatiedynamiek benadrukken
- Onderzoeksgenograms kunnen studie-identificaties en brontracking vereisen
Deze vereiste velden vormen de basisgegevensset die wordt gebruikt om de volledigheid te beoordelen.
Stap 2. — Controleer vastgelegde gegevens en informatiebronnen
Bekijk vervolgens of elk vereiste gegevenselement is gedocumenteerd.
In dit stadium is het ook belangrijk om te registreren waar de informatie vandaan kwam.
Familiegegevens kunnen afkomstig zijn van meerdere bronnen, zoals:
- deelnemers- of familiegesprekken
- medische of klinische dossiers
- geboorte-, overlijdens- of huwelijkscertificaten
- volkstelling of historische gegevens
- bewijs of juridische documentatie
- resultaten van genetische tests
- conclusies van onderzoekers op basis van beschikbare gegevens
Het registreren van informatiebronnen helpt onderzoekers na te gaan of gegevens worden geverifieerd, geschat of onzeker zijn, en maakt volledigheidsbeoordelingen gemakkelijker te interpreteren.
Als informatie niet beschikbaar is, markeer het dan als “Onbekend” in plaats van het veld leeg te laten.
Stap 3. — Schat het voltooiingspercentage in
Een eenvoudige manier om volledigheid te evalueren is om het aantal benodigde velden te vergelijken met het totale aantal velden dat voor het genogram is gedefinieerd.
Voorbeeld:
Vereiste velden: 20 Voltooid veld: 15
Geschatte volledigheidsscore: 20 = 75%
Dit percentage geeft een algemene indicatie van hoe volledig de dataset is.
Stap 4. — Het resultaat interpreteren
Onderzoekers kunnen volledigheidsbereiken gebruiken als praktische gids om analyse gereedheid te beoordelen.
Bijvoorbeeld:
- 0
- 20
- 40
- 60
- 80
Deze reeksen zijn geen vaste normen, maar kunnen teams helpen om te bepalen of extra gegevens moeten worden verzameld of geverifieerd alvorens het genogram voor onderzoek of professionele documentatie te gebruiken.
Voorbeeld van een volledigheidsscore
Het volgende voorbeeld laat zien hoe een genogram volledigheidsscore kan worden berekend met behulp van gewogen componenten.
| Onderdeel | score |
|---|---|
| Familiestructuur Volledigheid | 32 / 40 |
| Vereiste veldaanvulling | 23 / 30 |
| Brondocumentatie | 9 / 15 |
| Zekerheidsindicatoren | 6 / 10 |
| Evaluatiestatus | 3 / 5 |
**Totale score: 73 / 100
Dit genogram bevat de meeste benodigde informatie, maar er zijn nog een aantal lacunes. Bijvoorbeeld, ontbrekende brondocumentatie of onzekere gegevens kunnen het vertrouwen in interpretatie tussen de gevallen verminderen.
Zelfs wanneer een genogram goed scoort, is het nog steeds belangrijk om de gegevens voor consistentie, verificatie en afstemming met de onderzoeksdoelstellingen te herzien.
Sjablonen voor scoring van genogramgegevensvolledigheid
1. Basissjabloon voor scoring van genogramgegevensvolledigheid
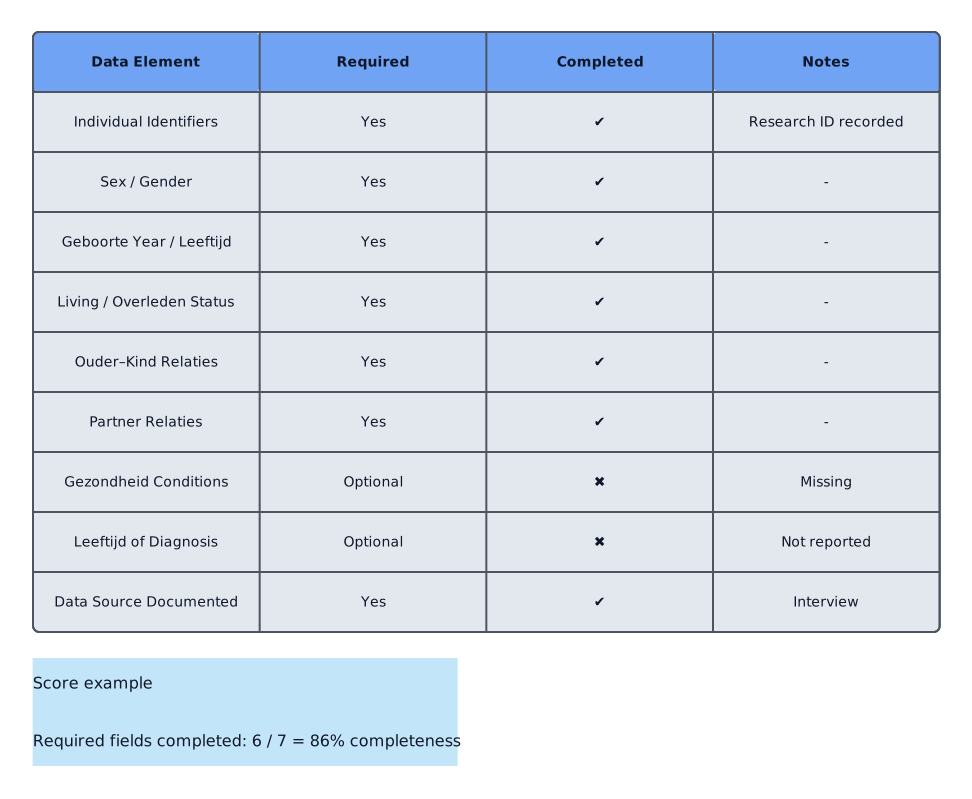
Deze eenvoudige sjabloon werkt goed voor individuele casusbeoordelings of kleine studies. Het helpt onderzoekers controleren of de essentiële gegevensvelden in een genogram zijn gevangen. Elk vereiste gegevenselement wordt gemarkeerd als voltooid of ontbreekt, waardoor het gemakkelijk is om een totale volledigheidsscore te berekenen.
- Klaar voor gebruik
- Volledig aanpasbare sjabloon
- Binnen enkele seconden aan de slag
 Close
2. Gewogen sjabloon voor scoring van genogramvolledigheid
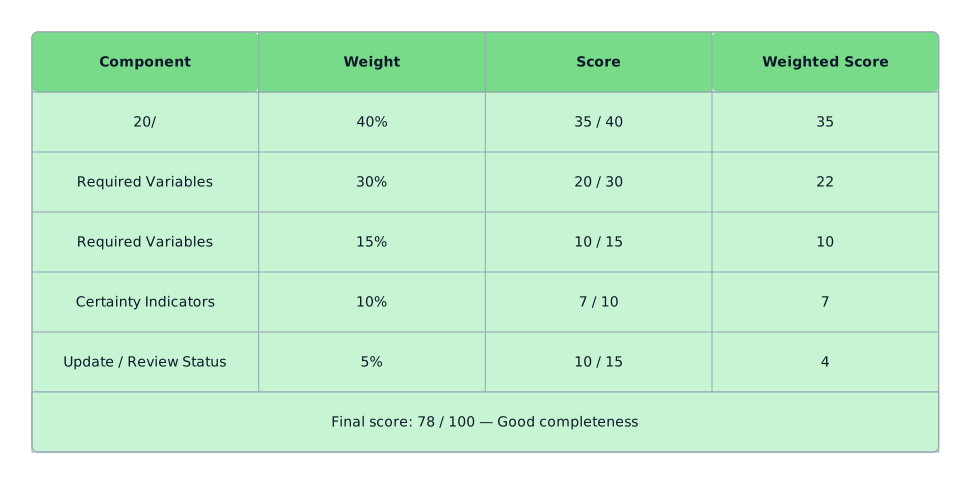
Deze sjabloon is nuttig voor meer gestructureerde onderzoeksprojecten waarbij verschillende soorten gegevens verschillende niveaus van belang hebben.
Zo kan informatie over de kernfamiliestructuur zwaarder worden gewogen dan ondersteunende metagegevens, zoals documentatienotities of updatestatus.
- Klaar voor gebruik
- Volledig aanpasbare sjabloon
- Binnen enkele seconden aan de slag
Close3. Genogramdatasetsjabloon voor meerdere cases
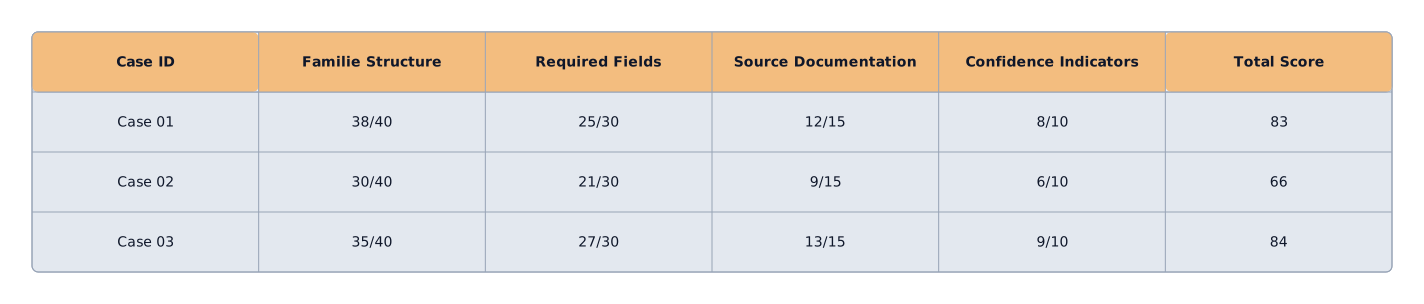
Deze sjabloon is ontworpen voor grote onderzoeksdatasets met meerdere families of casestudy’s.
Het stelt onderzoekers in staat om volledigheidsscores te vergelijken over meerdere genogrammen en snel te identificeren welke gevallen extra gegevensverzameling of verificatie vereisen.
- Klaar voor gebruik
- Volledig aanpasbare sjabloon
- Binnen enkele seconden aan de slag
Close4. Sjabloon voor gegevensvolledigheid op individueel niveau
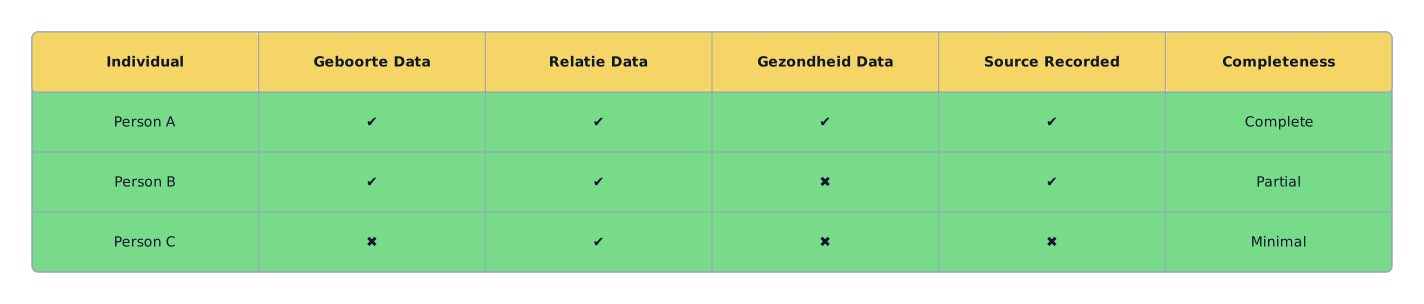
In plaats van een heel genogram tegelijk te scoren, beoordeelt dit sjabloon de volledigheid op individueel niveau. Deze aanpak werkt goed voor grote gezinsstructuren waar sommige individuen mogelijk onvolledige gegevens hebben.
Onderzoekers kunnen dan een volledigheidsscore op familieniveau berekenen op basis van de volledigheid van elke individuele dossier.
- Klaar voor gebruik
- Volledig aanpasbare sjabloon
- Binnen enkele seconden aan de slag
CloseCreately gebruiken om volledige genogrammen te bouwen en te beoordelen
Het behouden van volledige en consistente genogramdatasets kan een uitdaging zijn, vooral in onderzoeksinstellingen waarbij meerdere families betrokken zijn, zich ontwikkelende records of gezamenlijke gegevensverzameling.
Met behulp van een gestructureerd visueel platform zoals Creately kunnen onderzoekers helpen de vereiste informatie systematischer vast te leggen en genogrammen efficiënter te beoordelen bij het toepassen van volledigheidsscoremethoden.
Hier zijn een paar manieren Creately kan ondersteunen onderzoek-ready genogram documentatie.
Documenteer familierelaties consistent
Creately biedt gestructureerde relatie notatie die onderzoekers kan helpen om biologische, juridische en sociale verbindingen duidelijk te vertegenwoordigen. Dit ondersteunt de volledigheid van de familiestructuur, waardoor het gemakkelijker wordt om te bevestigen dat de vereiste verwantschapslinks en generatierelaties zijn geregistreerd voordat de dataset wordt gescoord.
Leg gestructureerde gegevens vast in elk individueel dossier
Onderzoekers kunnen gestructureerde datavelden rechtstreeks aan individuen in het genogram koppelen. Deze gebieden kunnen demografische variabelen, studie-relevante aandoeningen, juridische rollen of onderzoeksidentificaties omvatten. Dit ondersteunt de vereiste veld volledigheid, zodat teams kunnen controleren of essentiële variabelen zijn vastgelegd voor elk geval.
Genereer eerste genogrammen uit casusnotities
Creately Het opzetten van een eerste structuur vroeg in het documentatieproces ondersteunt dataset initialisatie en volledigheid review, waardoor het gemakkelijker is om ontbrekende individuen of relaties te identificeren.
Beoordeel grote meergenerationele families eenvoudiger
Automatische lay-out functies helpen te behouden leesbaarheid als genogrammen uitbreiden over generaties. Dit kan structurele verificatie ondersteunen, waardoor onderzoekers complexe diagrammen kunnen scannen op hiaten zoals niet opgenomen familieleden, onduidelijke relatielinks of onvolledige branches die de volledigheidsscore kunnen beïnvloeden.
Ondersteun gezamenlijke gegevensbeoordeling
Gedeelde werkruimten laten meerdere medewerkers toe om genogrammen na verloop van tijd te beoordelen en te verfijnen. Collaborative review ondersteunt update- en verificatiestatus, helpt teams de nauwkeurigheid van de gegevens te bevestigen, documentwijzigingen te wijzigen en te handhaven meer consistente volledigheidsniveaus in meerdere gevallen.